Ensembl ontsluit negen miljard DNA-voorspellingen
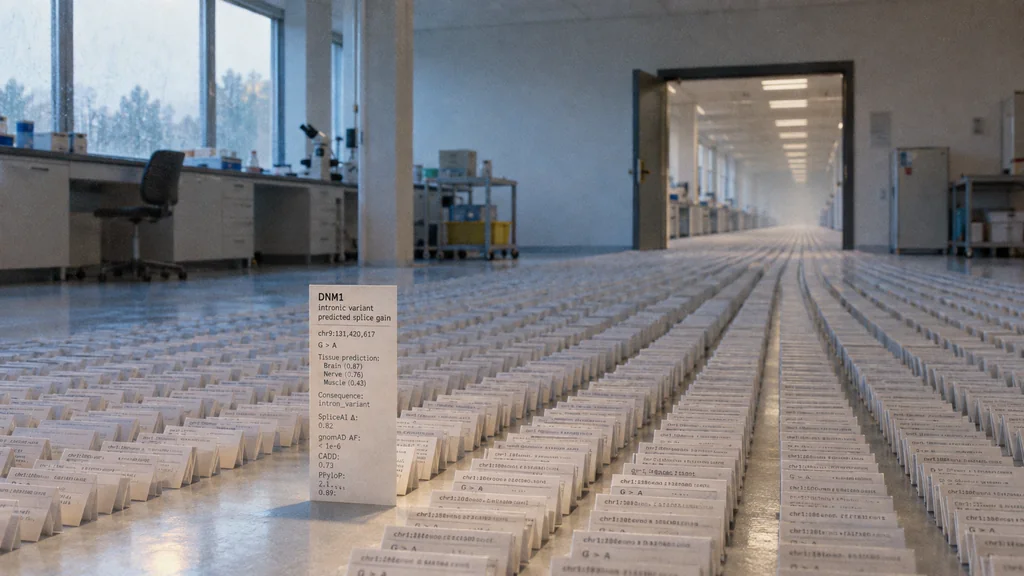
One predicted mutation rises, but only an experiment can confirm it.
Beeldcompositie · tobriefHet menselijke referentiegenoom is een standaardweergave van onze ongeveer drie miljard DNA-posities. Op elke positie staat een van vier chemische letters. Wordt zo'n letter vervangen door een van de drie alternatieven, dan ontstaat een denkbare mutatie. Google DeepMind liet zijn AlphaGenome-model alle mogelijke vervangingen van één letter doorrekenen. Dat leverde ongeveer negen miljard vermeldingen op, met per vermelding gemiddeld circa 27.000 moleculaire voorspellingen voor verschillende weefsels en celtypen (DeepMind). De daaruit voortgekomen Atlas omvat ook meer dan 100 miljoen korte invoegingen en verwijderingen die al in populatiedatabanken zijn vastgelegd (Atlas-preprint).
Experimentele metingen zijn deze vermeldingen niet. Ze beschrijven wat er volgens het model zou veranderen wanneer een bepaalde vervanging optreedt. De praktische vraag is of onderzoekers daarmee de genetische varianten kunnen vinden die er werkelijk toe doen.
Een verborgen variant, een aanwijzing uit de hersenen
De concreetste praktijktest betreft iemand met ernstige epileptische encefalopathie bij wie genetisch onderzoek geen oorzaak had opgeleverd. Onderzoekers van het Broad Institute gebruikten samen met het GREGoR Consortium en het AlphaGenome-team de samenvattende Atlasscore AVI (AlphaGenome Variant Impact) om de varianten van de patiënt opnieuw te rangschikken. Daardoor kwam een verandering naar voren die diep verscholen lag in een intron van het gen DNM1 (Fortune). Een intron is een stuk DNA dat uit het RNA wordt geknipt voordat de genetische instructies in een eiwit worden omgezet. Zulke gebieden krijgen doorgaans weinig aandacht. Eerder RNA-onderzoek in bloed had bovendien niets opgeleverd, omdat DNM1 in bloedcellen nauwelijks actief is.
Uit een afzonderlijke toeschrijvingsanalyse bleek dat naar schatting 69% van het AVI-signaal voortkwam uit voorspelde effecten op de RNA-splitsing, het proces waarbij cellen RNA knippen en samenvoegen voordat ze eiwitten maken. Volgens het model zou de variant in een hersenspecifieke versie van het gen een abnormale splitsingsplaats creëren, waardoor het uiteindelijke eiwit 13 extra aminozuren zou bevatten (Fortune; DeepMind). Een laboratoriumtest liet vervolgens dezelfde verandering in de RNA-splitsing zien. Daarop werd de variant opnieuw ingedeeld als waarschijnlijk ziekteverwekkend, een formele categorie waarin familiegeschiedenis, overerving en functionele gegevens samenkomen (Atlas-preprint).
Juist de volgorde laat zien wat het model wel en niet deed. De score zette de variant hoog op de kandidatenlijst, waarna de toeschrijvingsanalyse de onderzoekers naar een test van de RNA-splitsing leidde. Die proef bevestigde de voorspelde verstoring. AlphaGenome stelde dus niet zelfstandig de diagnose; bovendien beschrijft de publicatie niet alle stappen die tot de nieuwe classificatie hebben geleid (Nature).
De vergelijking en de volgende stap
De Atlas-preprint bevat retrospectieve vergelijkingen met reeds opgeloste gevallen van zeldzame ziekten uit het GREGoR Consortium. In 29,5% van de gevallen plaatste AVI de bekende oorzakelijke variant bij de vijftig hoogst gerangschikte kandidaten van een patiënt. Bij CADD, het al langer gebruikte scoresysteem voor het hele genoom, was dat 12,5% (Atlas-preprint). Het verschil was het grootst in niet-coderende gebieden. Die vormen het overgrote deel van het genoom, maar liggen buiten de DNA-recepten voor eiwitten en zijn daarom traditioneel lastig te duiden. DeepMind-onderzoeker Žiga Avsec erkent overigens dat het model sommige effecten van enhancers minder goed voorspelt. Dat zijn verderop gelegen DNA-segmenten die de activiteit van genen regelen (Fortune).
Het gaat hier om rangschikkingen binnen zorgvuldig geselecteerde, al opgeloste ziektegevallen, uitgevoerd met medewerkers van DeepMind en gepubliceerd als preprint. Achteraf het bekende antwoord terugvinden is immers iets anders dan meer diagnoses stellen bij patiënten voor wie werkelijk nog geen verklaring bestaat.
Op 9 september maakte het Europese publieke bio-informaticacentrum EMBL-EBI bekend dat de AVI-score voortaan beschikbaar is via de Ensembl Variant Effect Predictor (VEP). Onderzoekers gebruiken dit annotatiesysteem om ruwe genetische gegevens om te zetten in interpreteerbare resultaten (EMBL-EBI). VEP maakt al deel uit van de gegevensverwerking in klinische en onderzoekslaboratoria. Dankzij de toevoeging kan een laboratorium de AVI-score in dezelfde geautomatiseerde verwerking ophalen als de gevolgen voor genen en de frequenties in populaties, zonder daarvoor naar een afzonderlijk Google-portaal te hoeven. De integratie maakt de score toegankelijk, maar is geen bevestiging van de klinische betrouwbaarheid ervan. DeepMind stelt zelf dat AlphaGenome nog niet voor klinisch gebruik is gevalideerd of goedgekeurd (DeepMind).
In het beschreven geval met DNM1 hielp AlphaGenome onderzoekers een eerder gemiste variant bovenaan de lijst te krijgen. Ook leverde het een hypothese over de RNA-splitsing die in het laboratorium kon worden getoetst. Of deze werkwijze op grotere schaal daadwerkelijk meer diagnoses oplevert, moeten prospectieve onderzoeken van onafhankelijke groepen uitwijzen, met nog onopgeloste ziektegevallen in plaats van historische antwoorden.
Details about this article
- Model:
- claude-opus-4-6
- Generated:
- 9/10/2026, 2:07:54 AM
- Pipeline run:
- eu_pipeline_20260910_005006
- Watermark:
- SynthID (Google's invisible watermark)
- Human review:
- None before publication